Este post surge de la lectura de ReviewBench: an open benchmark for AI code review, publicado por GitHub el 5 de octubre de 2026. Es un benchmark para agentes de code review: 219 pull requests públicos de 187 repositorios, con un conjunto de hallazgos de referencia construido y validado con cuidado. El ranking es lo de menos. Lo que me llevo son dos ideas:
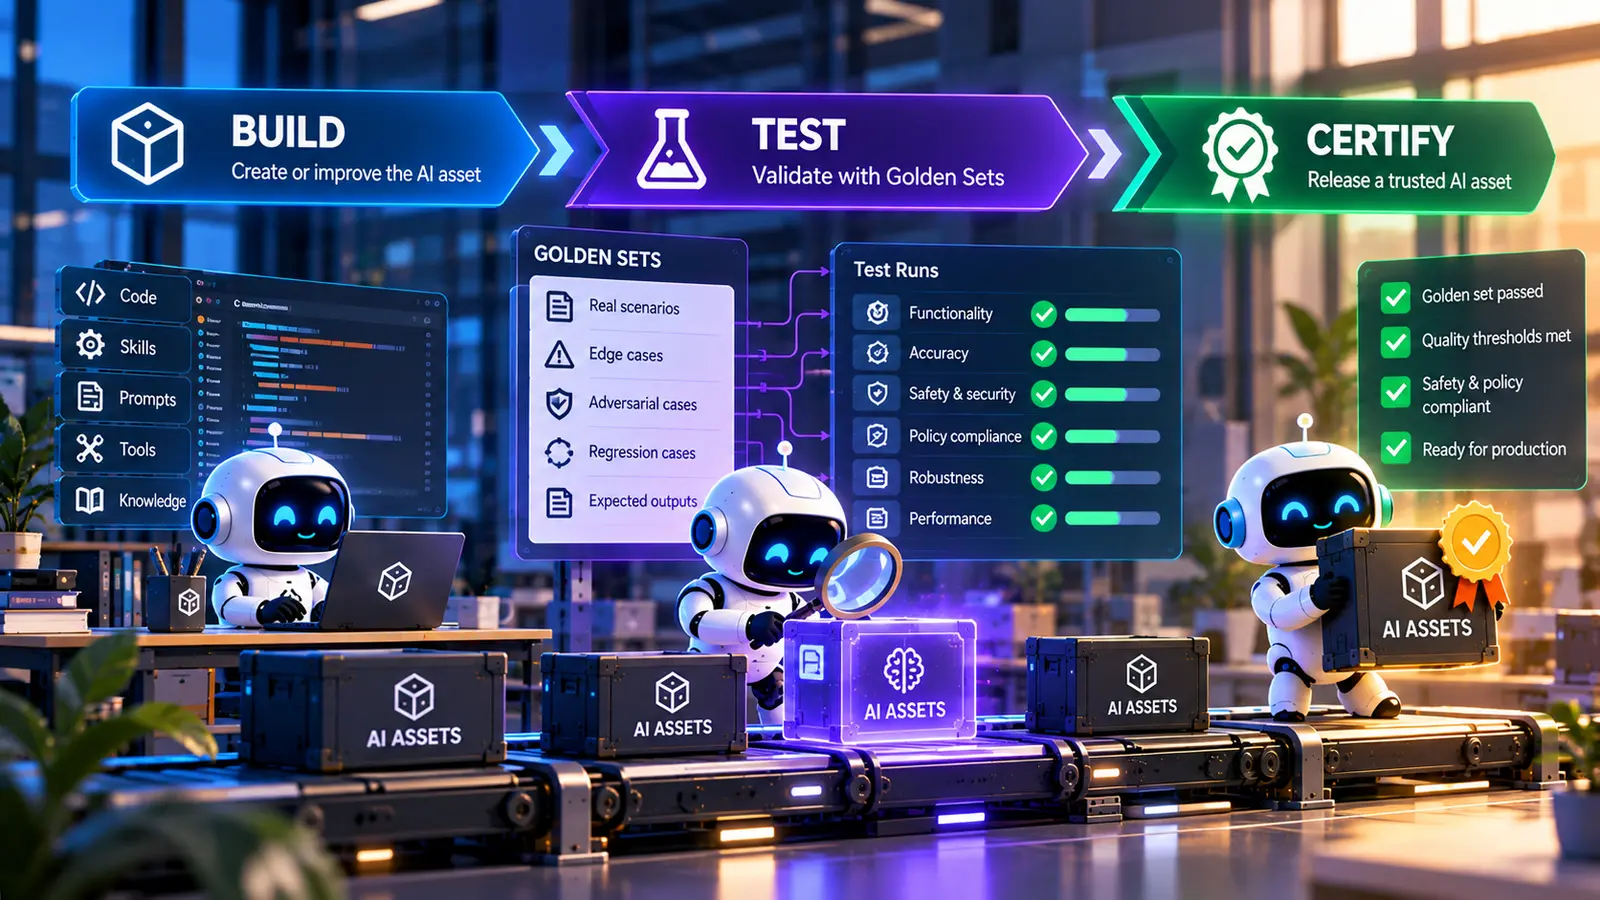
- Un golden set: un conjunto fijo de casos con la respuesta correcta conocida.
- Un pipeline de evaluación: una forma repetible de ejecutar tu sistema contra esos casos y puntuarlo.
Y un dato que explica por qué importan. GitHub usó ReviewBench para evaluar un cambio en su revisor de código antes de probarlo con usuarios en un experimento A/B. El benchmark predijo un aumento del 227% en comentarios críticos, y el A/B dio un 262%. La evaluación offline anticipó lo que luego pasó con usuarios reales.
Esta guía monta ese patrón a pequeña escala. Da igual qué estés cambiando: el prompt, el modelo, una skill o las herramientas de un agente. Sin un golden set y un pipeline, cada cambio que “parece que va mejor” es una impresión, no una medida.
El caso de ejemplo
El sistema bajo prueba es un clasificador de tickets de soporte: recibe el texto de un ticket y devuelve una de cuatro categorías, facturación, bug, acceso o petición.
Los tickets son ficticios y están construidos para ilustrar el método. Las cifras que verás en esta guía sí son reales: salen de ejecutar el pipeline con un modelo local. Pero no miden la calidad de ningún modelo, porque el set es pequeño y está diseñado para enseñar.
Esto no es un agente, es una sola llamada a un LLM. Lo he elegido así a propósito: la respuesta es exacta, así que se puntúa sin ambigüedad y se ve el esqueleto entero. Ese esqueleto (casos, ejecución, puntuación, comparación) es el mismo cuando detrás hay un agente; al final de la guía cuento qué cambia.
Todo el código, el golden set y los runs están en pmeleroa/lab-golden-set-eval. Para ejecutarlo necesitas Python 3 y Ollama en marcha. Si no lo tienes, la guía Ollama: primeros pasos hacia un asistente de código local explica cómo instalarlo. Los comandos son para una terminal Linux, y son idénticos en macOS. En Windows, usa WSL2 (guía de instalación de Microsoft).
ollama pull qwen2.5:7b
git clone --branch v1.0 https://github.com/pmeleroa/lab-golden-set-eval.git
cd lab-golden-set-eval
Uso qwen2.5:7b, un modelo generalista de unos 4.7GB. No es una recomendación: es el que uso para ilustrar.
Montar el golden set
Un golden set no se recopila, se diseña. Estas son las decisiones que lo hacen útil.
Primero el criterio, después los casos
Antes de escribir un solo ticket, escribe cómo se etiqueta. Sin un criterio, los casos dudosos se etiquetan según el día, y el golden set acaba midiendo tu humor. ReviewBench hace lo mismo con una rúbrica común para validar cada hallazgo.
La guía de etiquetado del ejemplo define las cuatro categorías y cuatro reglas. Estas son las tres que deciden los casos difíciles:
- Se etiqueta por lo que hay que hacer para resolverlo, no por las palabras del ticket. “La página de facturas da error” es
bug, aunque diga “facturas”: hay que arreglar la página, no revisar un cobro. - Si el ticket mezcla dos problemas, gana el que impide usar el producto ahora. Orden de desempate:
acceso>bug>facturación>petición. - Si algo funciona como está diseñado, es
petición, aunque la persona lo llame error. “No me deja exportar más de 1.000 filas” espeticiónsi ese límite existe a propósito.
Un caso por línea, con su porqué
Cada caso es una línea de JSONL con cinco campos: id, input, expected, dificultad y nota. Tres ejemplos:
{"id": "dev-01", "input": "Cuando intento guardar un proyecto nuevo me sale 'Error inesperado' y no se guarda nada.", "expected": "bug", "dificultad": "fácil", "nota": "Una función que falla con error."}
{"id": "dev-09", "input": "La página de facturas me da un error 500 cada vez que intento abrirla.", "expected": "bug", "dificultad": "trampa", "nota": "Regla 1: dice 'facturas', pero hay que arreglar la página, no revisar un cobro."}
{"id": "dev-22", "input": "No puedo entrar en mi cuenta y además me habéis cobrado dos veces este mes.", "expected": "acceso", "dificultad": "ambiguo", "nota": "Regla 2: mezcla acceso y facturación; gana acceso porque impide usar el producto ahora."}
La nota es lo que permite revisar el golden set meses después y discutir una etiqueta con argumentos. La dificultad permite ver dónde falla el sistema, no solo cuánto:
- fácil: una categoría evidente.
- ambiguo: encaja en dos categorías y decide una regla.
- trampa: las palabras del ticket apuntan a otra categoría.
Distribución con intención
El ejemplo tiene 40 casos. No están repartidos al azar:
- Las cuatro categorías aparecen en todos los splits.
- Hay casos difíciles a propósito: seis entre ambiguos y trampas en el set de desarrollo. Si todo es fácil, cualquier sistema saca nota y el golden set no distingue nada.
- Hay una categoría mayoritaria:
buges el 44% de los casos de desarrollo. Eso obliga a la métrica a tenerlo en cuenta. Un sistema que conteste siemprebugya acierta el 44% sin hacer nada.
Cuarenta casos son pocos. En el split de test, cada caso vale casi 7 puntos de accuracy, así que una diferencia de “un 7%” puede ser un único ticket. Para un ejemplo sirve. Para decidir en serio, necesitas más casos y mirar cuáles cambian, no solo el porcentaje.
Dos splits: uno para iterar y otro que no se mira
El golden set se parte en dos:
dev(25 casos): aquí iteras. Ejecutas, miras los fallos y cambias el sistema.test(15 casos): no se mira. Se ejecuta una sola vez, al final, con la versión definitiva.
El motivo es el error más común al evaluar: si iteras mirando los fallos hasta sacar un 100%, has ajustado tu sistema a esos casos concretos, no al problema. El split de test es la única forma de saber si la mejora se sostiene con casos que no has visto.
Y una vez fijado, el golden set no se toca. Si cambias un caso, los números anteriores dejan de ser comparables.
Montar el pipeline
El pipeline es un único script de Python, solo con la biblioteca estándar, con cinco etapas. Cada una deja algo en disco o en pantalla que puedes inspeccionar por separado.
1. Cargar el split
Lee dev.jsonl o test.jsonl y calcula un hash del fichero. Ese hash viaja con cada run y permite detectar que dos runs no se hicieron sobre la misma versión del golden set.
2. Ejecutar y guardar el run
Para cada caso, llama a la API local de Ollama con el prompt de sistema y el texto del ticket:
    peticion = {
        "model": modelo,
        "messages": [
            {"role": "system", "content": prompt},
            {"role": "user", "content": ticket},
        ],
        "stream": False,
        "options": {"temperature": temperatura, "seed": seed},
    }
Las respuestas se guardan en crudo en un fichero de run, junto con la configuración que las produjo:
{
  "modelo": "qwen2.5:7b",
  "temperatura": 0.0,
  "seed": 42,
  "prompt": "v1.txt",
  "prompt_sha": "96a29518",
  "split": "dev",
  "split_sha": "fb45641d",
  "fecha": "2026-10-08T20:31:07"
}
Sin esa configuración, dentro de dos semanas tendrás un 88% y no sabrás qué prompt ni qué modelo lo produjo. Y como la respuesta se guarda en crudo, puedes cambiar la forma de puntuar y volver a calcular los números sin llamar otra vez al modelo:
python3 eval.py report runs/dev-v2.jsonTemperatura 0 y seed fijo reducen la variación entre ejecuciones, pero no la eliminan. En mi máquina, dos ejecuciones idénticas del mismo prompt dieron 24 de 25 respuestas iguales, no 25. Para entrar en su leaderboard, ReviewBench pide ejecutar los 219 pull requests tres veces. Medir esa varianza queda fuera de esta guía, pero conviene saber que existe.
3. Normalizar
El modelo devuelve texto libre, y hay que llevarlo al conjunto cerrado de categorías:
def normalizar(respuesta):
    limpia = sin_tildes(respuesta.strip().strip(".\"'`*").lower())
    for categoria in CATEGORIAS:
        if limpia == sin_tildes(categoria):
            return categoria
    return INVALIDO
Acepta diferencias menores (mayúsculas, un punto final, una tilde que falta), pero nada más. Lo que no encaja se marca como inválido y se cuenta aparte. No es lo mismo que el modelo se equivoque de categoría que no siga el formato. Son problemas distintos y se arreglan de forma distinta.
4. Puntuar
Una accuracy suelta engaña, así que el informe da varias vistas:
- Accuracy junto al baseline: el baseline es lo que acertarías contestando siempre la categoría más frecuente. Un 60% parece algo hasta que ves que el baseline es un 44%.
- Precisión y recall por categoría: una accuracy alta puede esconder una categoría que nunca se acierta.
- Matriz de confusión: qué categoría se confunde con cuál.
- Desglose por dificultad: si fallan los casos fáciles, el problema es otro que si fallan los ambiguos.
5. Comparar caso a caso
Al ejecutar una nueva versión, se compara con el run anterior caso a caso: qué casos pasan de fallo a acierto y cuáles al revés. Un +3% global puede esconder cuatro arreglos y tres regresiones, y las regresiones son lo que importa. El script se niega a comparar runs hechos sobre versiones distintas del split.
python3 eval.py run --split dev --prompt prompts/v2.txt --comparar runs/dev-v1.jsonLeer los resultados e iterar
Estas son las tres iteraciones que hice sobre dev y la ejecución final sobre test. Todos los runs están en el repositorio.
25 inválidas
bug (44% en dev, 40% en test). Datos de los runs del tag v1.0.Run 1: un 0% que no es lo que parece
El primer prompt es lo que escribiría cualquiera sin pensarlo mucho:
Eres un asistente del equipo de soporte. Clasifica el ticket del cliente en una de estas categorías: facturación, bug, acceso, petición.Resultado:
Accuracy:           0/25 = 0%
Baseline ('bug' siempre): 11/25 = 44%
Respuestas inválidas: 25
Un 0% parece un desastre, pero las 25 respuestas son inválidas. En 23 de ellas aparecía la categoría correcta, pero dentro de frases como 'Categoría: Bug' o de una explicación entera. No es un problema de clasificación, es de formato. Sin la etapa de normalización separando los inválidos, habrías concluido que el modelo no sirve para la tarea.
Run 2: arreglar el formato
El segundo prompt añade una sola línea:
Responde únicamente con el nombre de la categoría, en minúsculas y sin ningún otro texto.Accuracy: 22/25 = 88%
Baseline ('bug' siempre): 11/25 = 44%
Respuestas inválidas: 0Por dificultad, los 19 casos fáciles salen bien y fallan 3 de los 6 difíciles: dev-09 y dev-24 (trampas) y dev-11 (ambiguo). El golden set hace su trabajo, porque los fallos están justo donde se diseñaron.
Run 3: añadir el criterio
El tercer prompt incorpora las definiciones y las reglas de la guía de etiquetado. Son criterios generales, no parches para los tres casos que fallaban.
Accuracy:           25/25 = 100%
...
Frente a v2.txt (5597308a)
  Arreglados (3):  dev-09, dev-11, dev-24
  Regresiones (0): -
Un 100% en dev. Aquí es donde es fácil darlo por terminado, y por eso existe el split de test.
La prueba de verdad: test
Una sola ejecución del prompt final sobre los 15 casos que no había mirado:
Accuracy:           14/15 = 93%
Baseline ('bug' siempre): 6/15 = 40%
Respuestas inválidas: 0
El 100% no se sostiene. El único fallo es test-07: “Quiero pasar del plan mensual al anual, ¿cómo lo hago?”, que el modelo clasifica como petición en vez de facturación. No es un caso difícil, es un caso fácil, y de un tipo que no aparecía en dev: ningún ticket de desarrollo trataba de cambiar de plan. Mi hipótesis es que la definición de petición del prompt (“algo que funciona como está diseñado y se quiere cambiar”) atrae cualquier ticket que empiece por “quiero”, pero no lo he comprobado.
Hay tres lecciones en ese único caso:
- Un 100% en el set con el que iteras no demuestra nada hasta que lo confirma un set que no has mirado.
- El golden set también tiene huecos: a
devle faltaba cobertura de un tipo de ticket. - Con 15 casos, la diferencia entre 100% y 93% es un ticket. Hay que leer el caso, no solo el porcentaje.
Y una regla: después de ejecutar test no se retoca nada para mejorar ese número. Si lo haces, test se convierte en otro dev. El siguiente paso sería ampliar dev con casos de cambio de plan, iterar ahí y, para volver a medir de verdad, usar casos de test nuevos.
Del prompt al agente
El ejemplo es una sola llamada con respuesta exacta. Cuando el sistema bajo prueba es un agente o una skill, el patrón es el mismo, pero cambian varias piezas:
- La respuesta esperada deja de ser una etiqueta. Un agente casi nunca produce una respuesta exacta. Lo que se comprueba es el resultado (los tests pasan, el fichero existe, el ticket ha quedado en el estado correcto) y, a veces, la trayectoria: qué herramientas usó y qué no debía tocar y no tocó.
- La puntuación puede necesitar un juez. Cuando el resultado es texto libre (un resumen, una respuesta, un hallazgo de code review) no basta con comparar cadenas, y hace falta un juez: otro LLM o una rúbrica. ReviewBench usa un LLM como juez y distingue entre métricas grounded, que solo cuentan lo que está en el golden set, y augmented, en las que el juez puede dar por buenos hallazgos que el golden set no tenía. Pero un juez es otro sistema que se equivoca, y necesita su propio golden set. Las propias etiquetas también se miden: en ReviewBench, ingenieros senior ajenos al dataset re-etiquetaron desde cero cada hallazgo del golden set, y sus juicios coincidieron en un 96,6% de los casos.
- Una skill tiene dos preguntas. ¿Se activa cuando debe, y no se activa cuando no debe? ¿Hace bien la tarea una vez activada? Cada pregunta necesita sus propios casos en el golden set, incluidos casos en los que la skill no debería activarse.
- La variación entre ejecuciones crece. Un agente toma varias decisiones encadenadas, y una pequeña diferencia al principio cambia todo lo que viene después. Conviene ejecutar cada caso varias veces.
Lo que no cambia: criterio antes que casos, casos diseñados con intención, un split que no se mira, runs guardados con su configuración y comparación caso a caso.
Lo que esta guía no cubre
- Implementar un juez: el ejemplo tiene respuesta exacta y no lo necesita. Evaluar al evaluador es otro patrón, con entidad propia.
- Repeticiones y varianza: cada caso se ejecuta una sola vez.
- Salida estructurada: Ollama puede restringir la respuesta a un JSON Schema con el campo
format, lo que haría casi imposibles los inválidos del run 1. Lo dejo fuera a propósito, porque aquí los inválidos son parte de la lección. - Integración en CI: ejecutar el pipeline en cada cambio y bloquear los que empeoren.
En una empresa, no es opcional
Para un prototipo o una herramienta personal, montar todo esto puede no compensar, y probar a mano unos cuantos casos es razonable. Pero en una empresa con cierto grado de madurez, creo que un golden set y un pipeline de evaluación son completamente necesarios.
En cuanto varios equipos cambian prompts, modelos, skills o agentes que llegan a producción, sin evaluación cada cambio se aprueba por intuición, y las regresiones se descubren cuando ya las han sufrido los usuarios. Con evaluación, cada cambio llega con su informe: qué mejora, qué empeora y en qué casos. ReviewBench muestra que no es teoría: GitHub lo usa para decidir cambios de un producto en producción, y su predicción offline anticipó lo que luego midió el experimento real.
No hace falta empezar con 219 casos ni con un juez validado. Basta con 40 casos bien pensados, un split que no se mira y un script que guarde lo que ha pasado.